
GPT-6 Astra 소개: 무엇이 좋아졌고, 어떤 작업부터 맡겨볼까?
(해당 글은 GPT-6 Astra와 함께 작성되었습니다.)
만약 기존 GPT-5.6 Sol을 사용하면서도
“자료 조사부터 결과물 작성까지 조금 더 길게 맡길 수 없을까?”,
“코드를 만드는 데서 그치지 않고 화면까지 확인해주면 좋겠다”는 생각을 했다면
새로 공개된 GPT-6 Astra를 눈여겨볼 만합니다.
최신 프론티어 모델을 적극 활용하고자
ChatGPT Pro Plan을 구독하는 분들이 진정 궁금해하는 것은
'새 모델의 이름보다, 이제 어떤 일을 더 맡길 수 있느냐?'일 것입니다.
OpenAI는 GPT-6 Astra를
복잡한 추론과 코딩, 컴퓨터 조작, 조사와 문서 작성을 위한 모델로 소개합니다.
특히 코드·브라우저·전문 소프트웨어를 오가며 여러 단계의 작업을 이어가는 능력을 강조합니다. 공식 모델 소개
이 글에서는 Astra가 무엇을 더 잘하게 됐는지, 그 변화가 어떤 작업에서 유용할지 살펴보겠습니다.
이어서 Astra의 작업 성향을 이해하고, 익숙한 Sol 사용법을 내 업무에 맞게 조정하는 방법을 정리합니다.
구독 사용량과 API 이전·비용처럼 사용 경로에 따라 달라지는 정보는 글 뒤의 참고 안내에 모았습니다.
- 자료·가격 확인 기준: 2026년 9월 7일.
- 주의: 공개 평가와 사례를 검토한 글이며, 필자가 직접 수행한 실험은 아닙니다.
이 글의 순서
필요한 시작 정보는 참고 안내에서 골라 읽으셔도 됩니다.
1. 기존 모델도 잘 하던데, Astra에서는 무엇이 달라졌을까?
웹 앱 제작과 문서 작성은 기존 GPT-5.6의 Sol과 Terra, Luna도 잘 해내던 일입니다.
그럼에도 Astra를 주목할 이유는
같은 작업에서도 화면을 더 정확히 읽고, 조작에 드는 시간을 줄인 개선에 있습니다.
1.1 화면 인식·작업 수행·소요 시간의 변화
컴퓨터 조작(computer use)은 화면을 보고 클릭·입력하며 앱 안에서 일을 진행하는 능력입니다.
OpenAI가 공개한 평가 지표에서 그 변화를 살펴볼 수 있습니다.
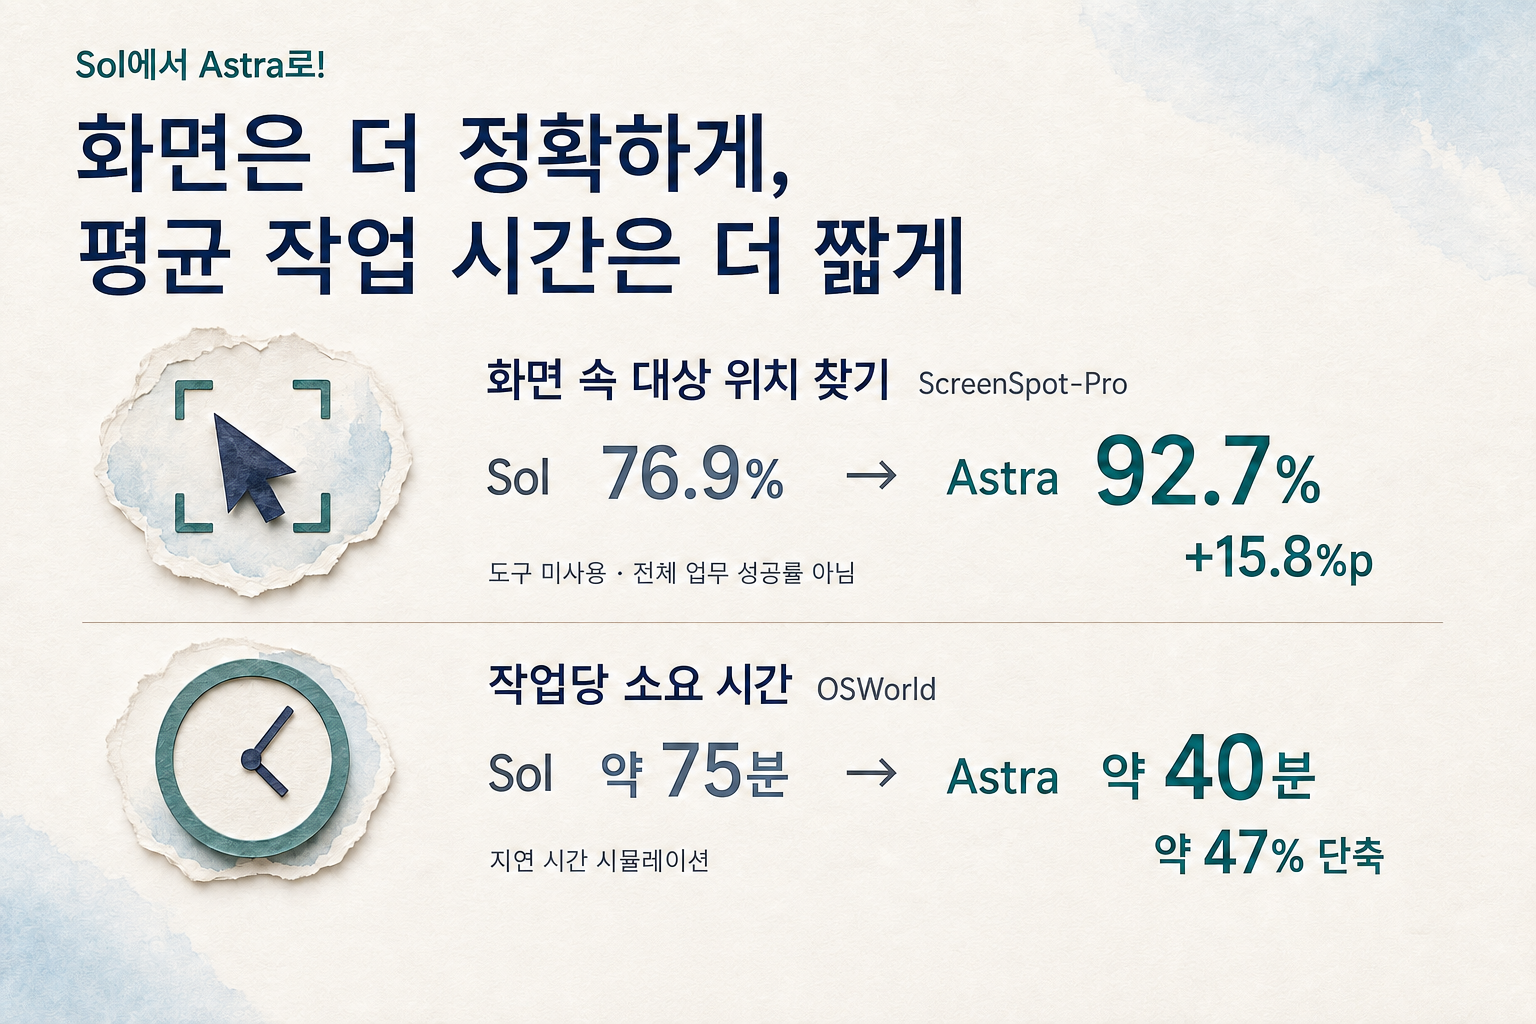
화면에서 대상을 찾는 능력, 앱 안에서 일을 수행하는 능력, 완료까지 걸린 시간으로 나눠 Astra와 Sol을 비교 평가한 수치는 다음과 같습니다.
| 무엇을 봤나 | Sol → Astra | 읽는 법 |
|---|---|---|
| ScreenSpot-Pro: 전문 앱 화면에서 지시한 대상 위치 찾기 | 76.9% → 92.7% | 도구 미사용 조건에서 15.8%포인트 상승 |
| OSWorld 2.0: 인터넷 없이 데스크톱 앱 작업 수행 | 65.7% → 72.6% | 완수한 부분에도 점수를 주는 평가 |
| OSWorld 작업당 시간 | 약 75분 → 40분 | 지연 시간 시뮬레이션에서 약 47% 단축 |
첫 번째는 화면의 어느 버튼이나 항목을 조작할지 찾는 능력입니다.
두 번째는 실제 앱에서 작업을 진행한 결과를 보며,
세 번째는 시뮬레이션에서 작업당 소요 시간이 얼마나 줄었는지 보여줍니다.
평가 지표 수치를 읽을 때는
비판적인 시각으로 바라봐야 할 요소들이 종종 발생하는데요.
위 경우에서 고려하면 좋을 요소 두 가지를 풀어드리려 합니다.
먼저, 이전 모델과 개선 모델을
동일한 추론 강도 조건 아래에서 비교한 게 아닐 수 있다는 점입니다.
표의 점수는 각 모델에서 추론 강도를 달리해 얻은 결과 중 가장 높은 값을 나타냅니다.
여기서 추론 강도는 문제를 생각하는 데 들일 노력을 조절하는 설정을 의미합니다.
각 모델이 선택 가능한 모든 추론 강도(low, medium, high, xhigh, max)를
일제히 테스트하고 그 중 제일 높은 수치로 대표한 결과라고 보면 되겠습니다.
물론 대부분 max, xhigh, high 중 하나가 가장 높게 나오곤 합니다.
다음은 OSWorld 작업 당 시간의 경우
실제 사용자 작업을 반복 측정한 값이 아닌 단순 시뮬레이션의 결과라는 점입니다.
평가 점수만 보고서 '이만큼 개선되었겠지?' 막연히 기대감을 높이기보다는
사용자의 실제 작업 환경과 업무 성격마다
모델의 실 사용 체감이 다를 수 있다는 것을 항상 염두해야 합니다. ScreenSpot-Pro 평가 설명, OpenAI 결과표·조건
1.2 웹 작업 속도와 실행 환경의 개선
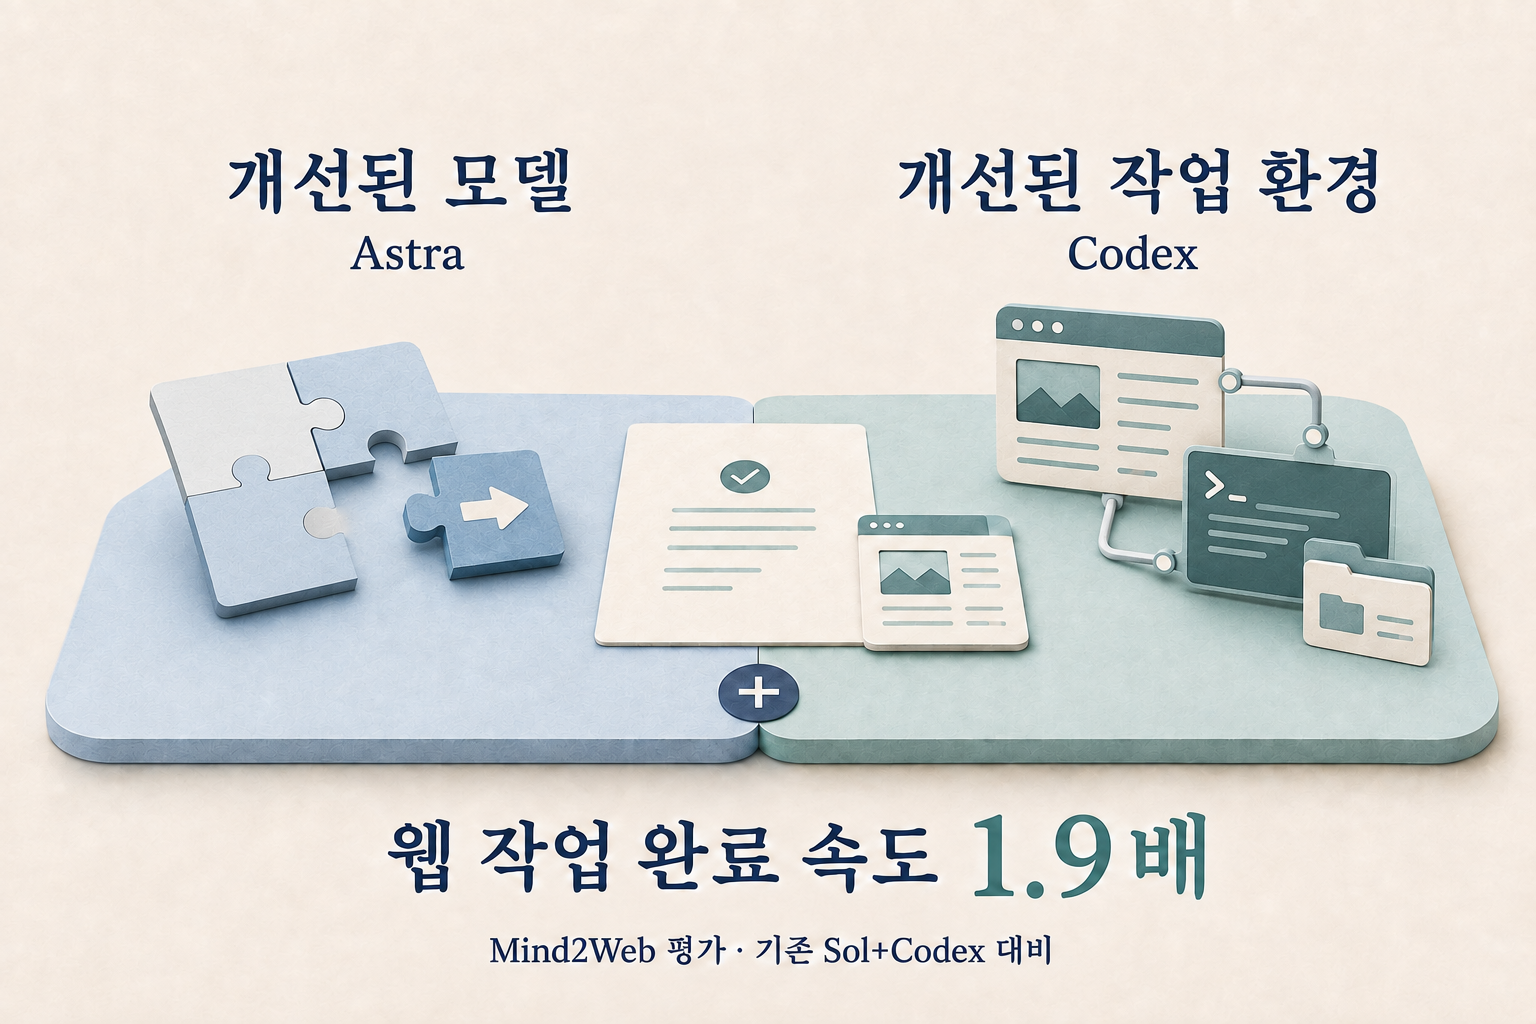
앞의 화면 인식·데스크톱 작업 평가와 별도로, 웹사이트 작업을 다루는 Mind2Web에서는 기존 Sol+Codex 환경보다 1.9배 빠른 완료를 발표했습니다.
해당 평가에서 흥미로운 부분은
모델뿐 아니라 이를 움직이는 프로그램(Codex) 개선까지 함께 비교했다는 점입니다.
코딩 에이전트의 경우, LLM 모델이 다음 행동을 판단하면
Codex와 같은 에이전트 런타임 실행 환경이 도구를 실행하고 결과를 LLM에게 다시 전달합니다.
OpenAI는 이 변경을 다음과 같이 설명합니다.
“Alongside Astra, we are also updating the Codex harness to significantly improve the speed of computer use.”
Astra 출시와 함께 Codex 하네스도 개선한다는 뜻입니다.
원문은 여기에 Astra의 효율 개선이 더해져 기존 Sol 사용 환경 대비 1.9배 빠른 작업 완료로 이어졌다고 설명합니다. 공식 발표 원문
따라서 1.9배를 모델 단독의 속도 향상이나 API 전환 효과로 해석하기는 어렵습니다.
모델과 런타임 실행 환경을 함께 발전시켜 실제 작업 시간을 줄였다는 점에 의미가 있습니다. OpenAI 속도 평가
1.3 벤치마크 점수와 실행 조건 함께 보기
이처럼 모델을 둘러싼 도구 연결·작업 기록·지시 파일 등의 환경을 ‘하네스’라고 부릅니다.
따라서 벤치마크 결과에는 모델뿐 아니라 하네스의 영향도 담길 수 있습니다.
낯선 게임의 규칙을 탐색하는 ARC-AGI-3 Semi-Private 평가가 한 가지 예입니다.
Astra는 같은 high 추론 강도에서 표준 환경 54.82%, 제공사 연동 환경 99.95%를 기록했습니다. ARC Prize 결과
다만 Astra가 ARC-AGI-3에서 99.95%를 달성했으니 최고다! 라고 순수하게 받아들이기에는 이견이 존재합니다.
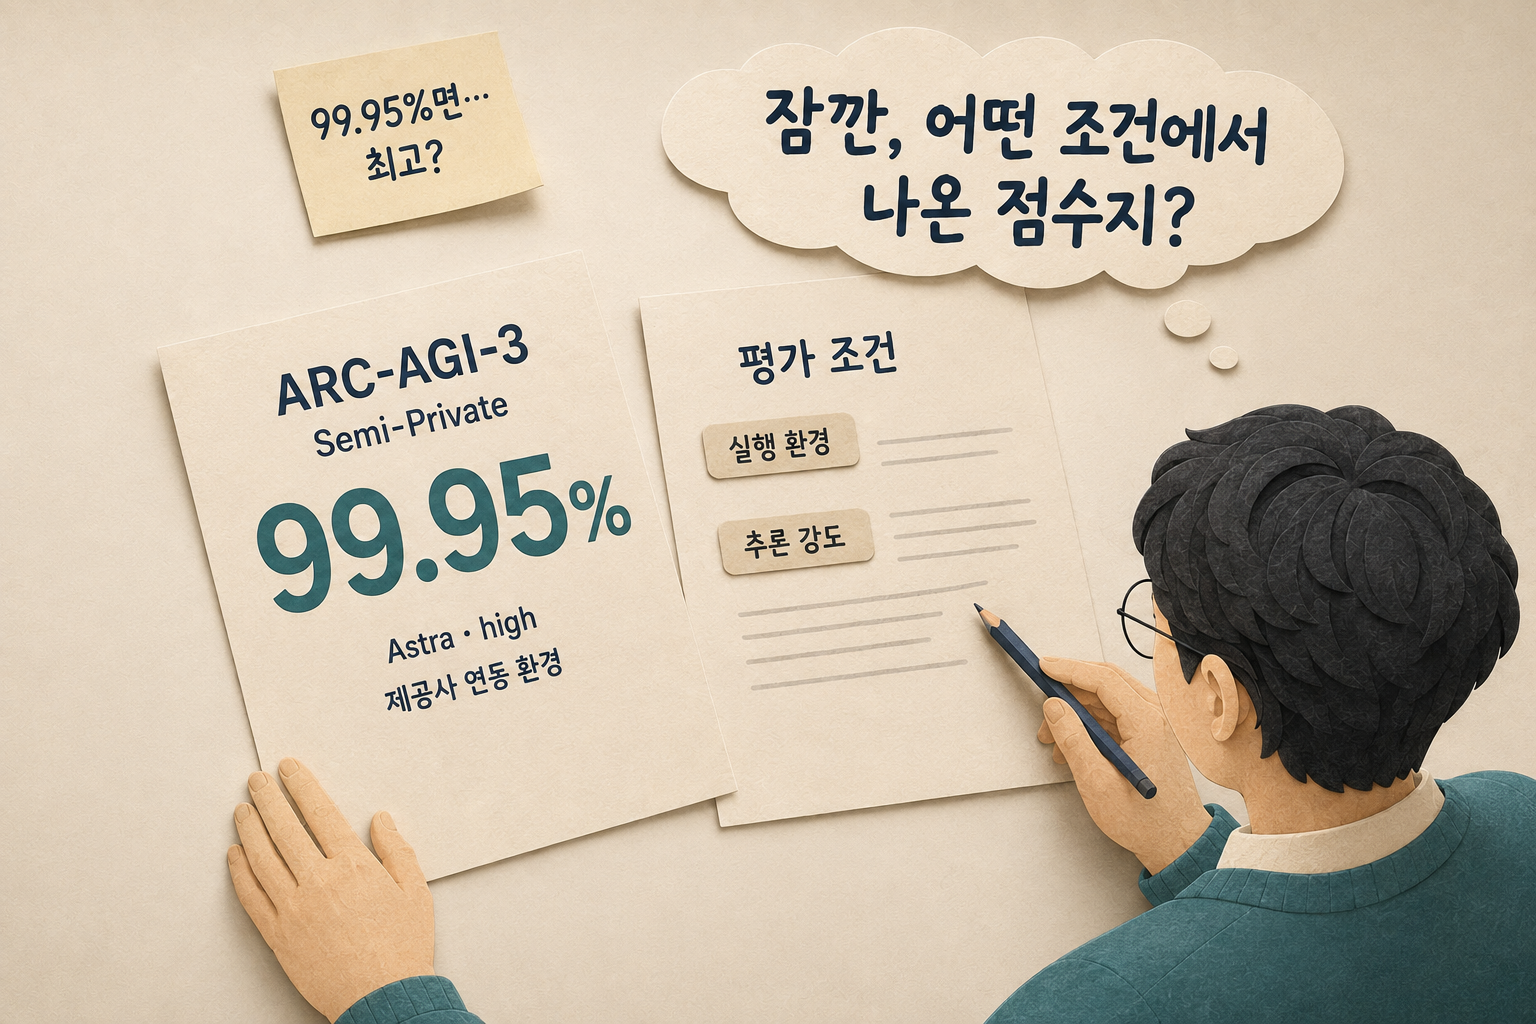
바로 '다른 모델군에 대해서도 제공사 연동 환경이 일치한 환경에서 결과를 확인해야 정당한 비교가 될 것이다!' 라는 주장인데요.
'표준 환경'과 '제공사 연동 환경' 두 환경은 앞서 시도한 내용을 다음 호출에 넘기는 방식이 다릅니다.
제공사 연동 환경은 추론 상태 보존과 긴 대화 압축을 활용합니다. 표준 환경보다 훨씬 최적화된 방식이라고 봐야겠죠.
"Provider Adapter, 제공사 연동 환경 하네스는 요청 간에 불투명한 추론 상태를 유지하고 더 긴 대화에 대해 압축을 사용하여 모델이 이전 작업을 재사용할 수 있도록 합니다."
결국 둘은 다른 조건에서 실행된 결과이기에
이전 모델과 개선 모델의 순수한 비교라고 보긴 어렵고,
ARC-AGI-3 스코어 차이를 모델 간 전체 성능 차이라고 단정할 수도 없습니다.
벤치마크는 모델의 능력을 가늠할 근거가 되지만, 순수히 점수만 보고 판단하기보다
점수가 나온 조건까지 함께 봐야 실제 어떤 의미가 담겨있는지 판단할 수 있습니다. 평가 환경 해설
물론 이런 평가 조건을 감안해도,
기존 GPT-5.6 모델군의 컴퓨터 조작에 만족했던 분들이
동일한 작업들을 Astra에게 다시 맡겨볼 이유는 있습니다.
이미 해낼 수 있던 일이라도 더 정확히 조작하고, 사람이 손봐야 할 부분을 줄일 여지가 생겼기 때문입니다.
공식 가이드는 사용자의 요구사항이 동적으로 추가되더라도
큰 목표를 유지하며 협업하는 능력이 개선되었음을 설명합니다.
앱을 만들다가 화면 구성을 바꾸거나 요구사항을 더하는 일은 실무에서 흔합니다.
처음 정한 목표를 놓치지 않고 변경 사항을 유연하게 이어받는 능력은, 실제 협업에서 체감해볼 만한 변화입니다. 모델 활용 가이드
2. 이런 작업부터 맡겨볼 만하다
2.1 앱을 만들고, 실제 화면에서 다듬기
이런 변화를 체감해볼 첫 작업으로는 작은 웹 앱이나 업무용 내부 도구 제작을 꼽고 싶습니다.
구현 뒤 브라우저에서 동작을 확인하고 화면을 다듬는 과정까지 함께 맡겨볼 수 있기 때문입니다.
한 가지 예시로, Kingy AI의 ‘SignalDesk’ 대시보드 제작 실험을 가져왔습니다.
해당 실험에서는 Astra와 Sol에 동일한 조건, 같은 자료·요구사항·추론 설정(xhigh)과 도구 환경을 제공했습니다.
검색·필터·항목 비교·상태 유지·모바일 화면 등이 모두 포함됐고, 두 모델 모두 기능 검사 12개를 통과했습니다.
즉, 검사한 기능은 두 모델 모두 잘 구현해냈습니다.
그 결과 별도 AI 리뷰어는
좁은 화면에서도 비교 정보를 함께 읽기 쉬운 Astra의 구성을 더 높게 평가했습니다.
반면 첫 완료 보고까지 걸린 시간은 Sol 14분 41초, Astra 16분 35초로
작업 실행 시간에서는 Astra가 더 오래 걸렸습니다.
한 번의 실행 만으로 일반화할 수는 없지만,
AI 리뷰어의 평가는 단순히 코딩 에이전트의 결과물을
일률적인 속도 우위 만으로 판단하기보다
실제로 작업을 시켜보며 기능 구현과 화면 완성도를 함께 살펴봐야 한다는 점을 상기해줍니다. 실험 원문
|
Astra mobile comparison |
Sol mobile comparison |
|---|---|
|
|
|
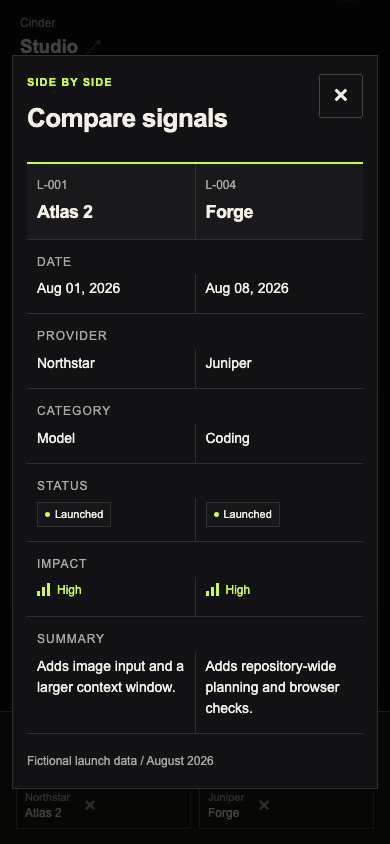
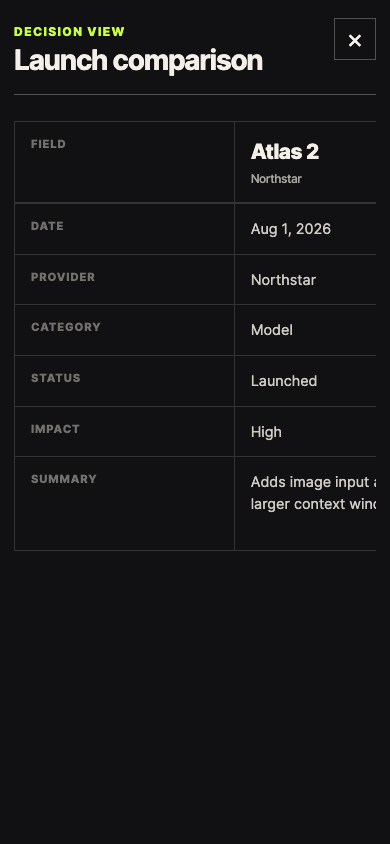
같은 요구사항으로 만든 두 SignalDesk 화면. 출처: Kingy AI.
2.2 전문 앱 안에서 여러 단계의 작업 이어가기
@choi.openai가 소개한 @GoGoFly23의 사례에서는
Astra가 전자회로 설계 도구 KiCad로 드론용 회로기판(PCB)의 설계·배선·오류 검사·제조 파일 출력까지 진행했다고 합니다.
다만 실제 보드 테스트는 아직 하지 않았다고 밝혔기에
'이런 것도 할 수 있어?' 소개 사례 정도로 참고하시면 좋겠습니다. 사례 소개
흥미로운 부분은 전문성이 높은, 난이도 높은 앱 안에서 설계부터 검사·출력까지 여러 단계를 연결했다는 점입니다.
KiCad를 이용한 드론용 PCB 설계 사례. 실제 보드 테스트는 아직 진행되지 않았다. 원 사례: @GoGoFly23, 소개: @choi.openai.
만약 자신의 업무에도 데스크탑 앱 환경에서 파일을 열고, 수정하고, 검사하고, 정해진 형식으로 내보내는 반복 과정이 있다면
Astra에게 맡겨볼 수 있겠습니다.
처음에는 검토 가능한 중간 결과까지 맡기고, 잘 수행하는 범위를 직접 확인하며 점차 다음 단계로 넓혀보길 제안합니다.
2.3 자료를 모아 검토 가능한 문서로 만들기
코딩 에이전트 기반 복잡한 업무나 개발 업무가 아니어도 Astra를 활용할 여지는 있습니다.
공식 소개는 문서·스프레드시트·발표 자료 제작과 기존 양식을 준수할 수 있도록 성능이 개선되었다고 강조합니다. 전문 업무 소개
예를 들어 여러 보고서를 읽어 쟁점을 정리하고
회의록에서 결정 사항을 추려 제안서 초안으로 연결해볼 수 있겠습니다.
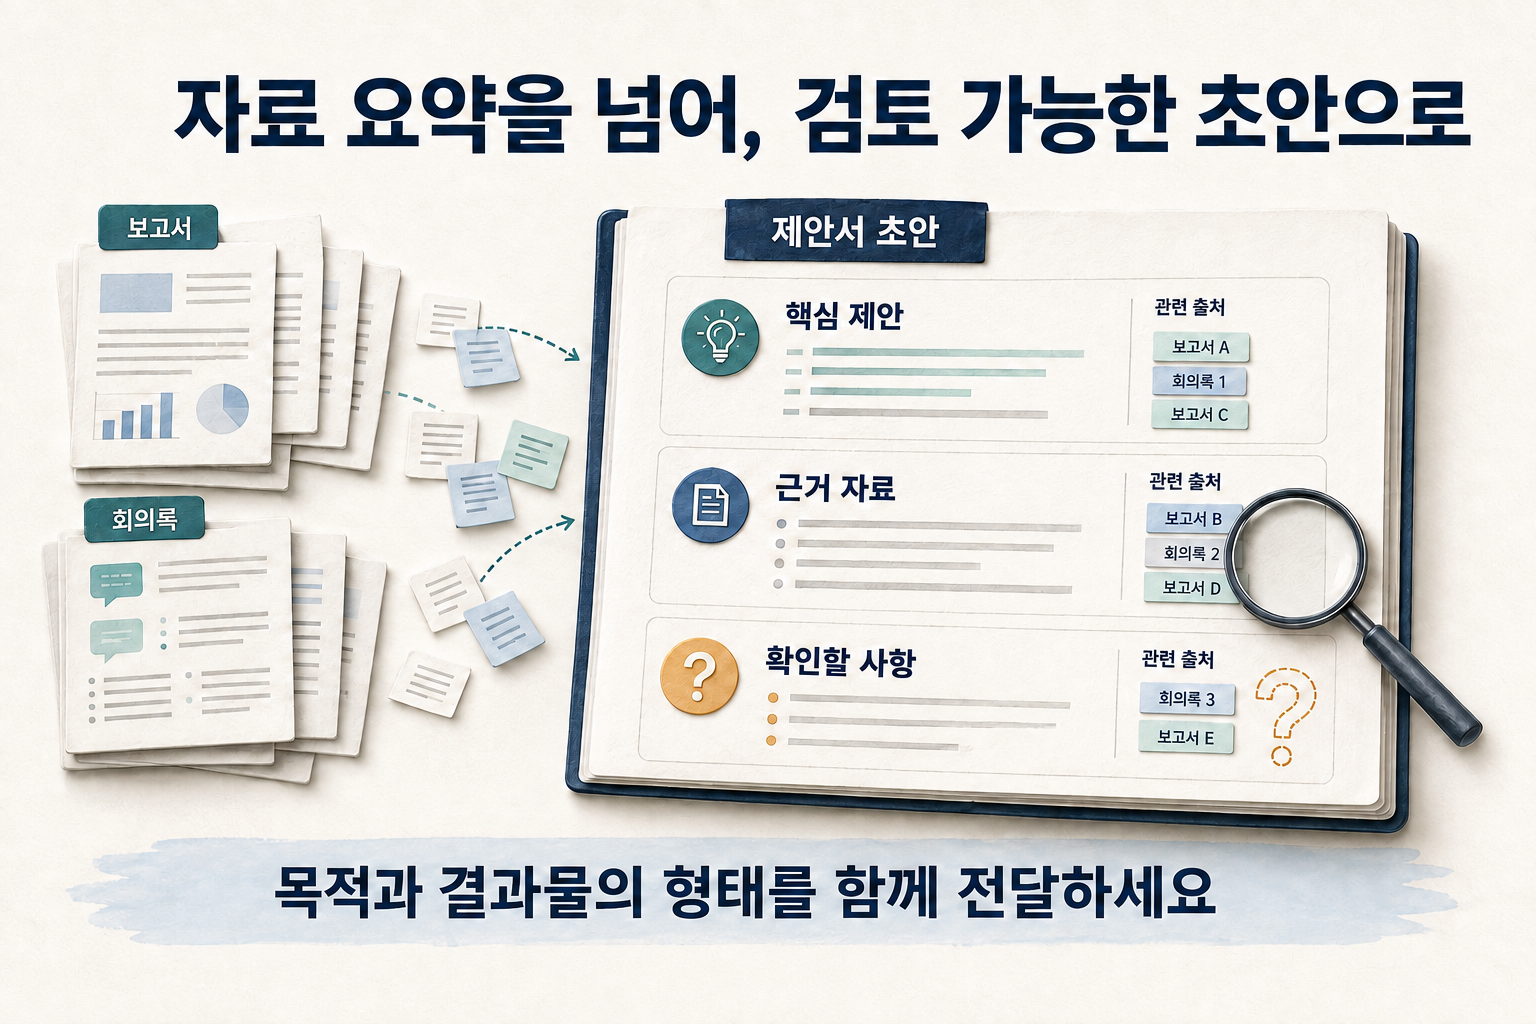
Astra의 성격을 고려했을 때 단순히 ‘요약해줘’라고 요청하기보다
자료를 읽는 목적과 최종 결과물의 형태를 함께 전달하면, 조사·작성·검토를 하나의 작업으로 맡기기 쉽습니다.
그렇다면 요구사항을 어디까지 자세히 알려주고, 무엇을 Astra의 판단에 맡기면 좋을까요?
3. Sol에서 넘어올 때는 익숙한 작업부터
Astra를 활용할 때는 성능뿐 아니라 일을 진행하는 성향도 알아두면 좋습니다.
공식 가이드는 Astra가 지시를 더 잘 따르는 한편, 답에 따라 결과가 달라질 수 있으면 확인 질문을 하는 경향에 대해 설명합니다.
사용자는 알아서 계속하기를 기대했는데 모델은 멈춰 묻는 상황이 생길 수 있다는 뜻입니다. 모델의 작업 성향
저는 이를 ‘주어진 지시대로 곧바로 일을 진행하는 쪽’에서,
필요한 부분은 되묻고, 원하는 결과와 판단을 맡길 범위가 분명해지면 꼼꼼하게 일을 이어가는 쪽으로 무게중심이 옮겨간 것으로 이해합니다.
다만 사용자 입장에서는 ‘지시를 꼼꼼히 정리해줘야 제대로 일한다’는 부담으로 느껴질 수도 있습니다.
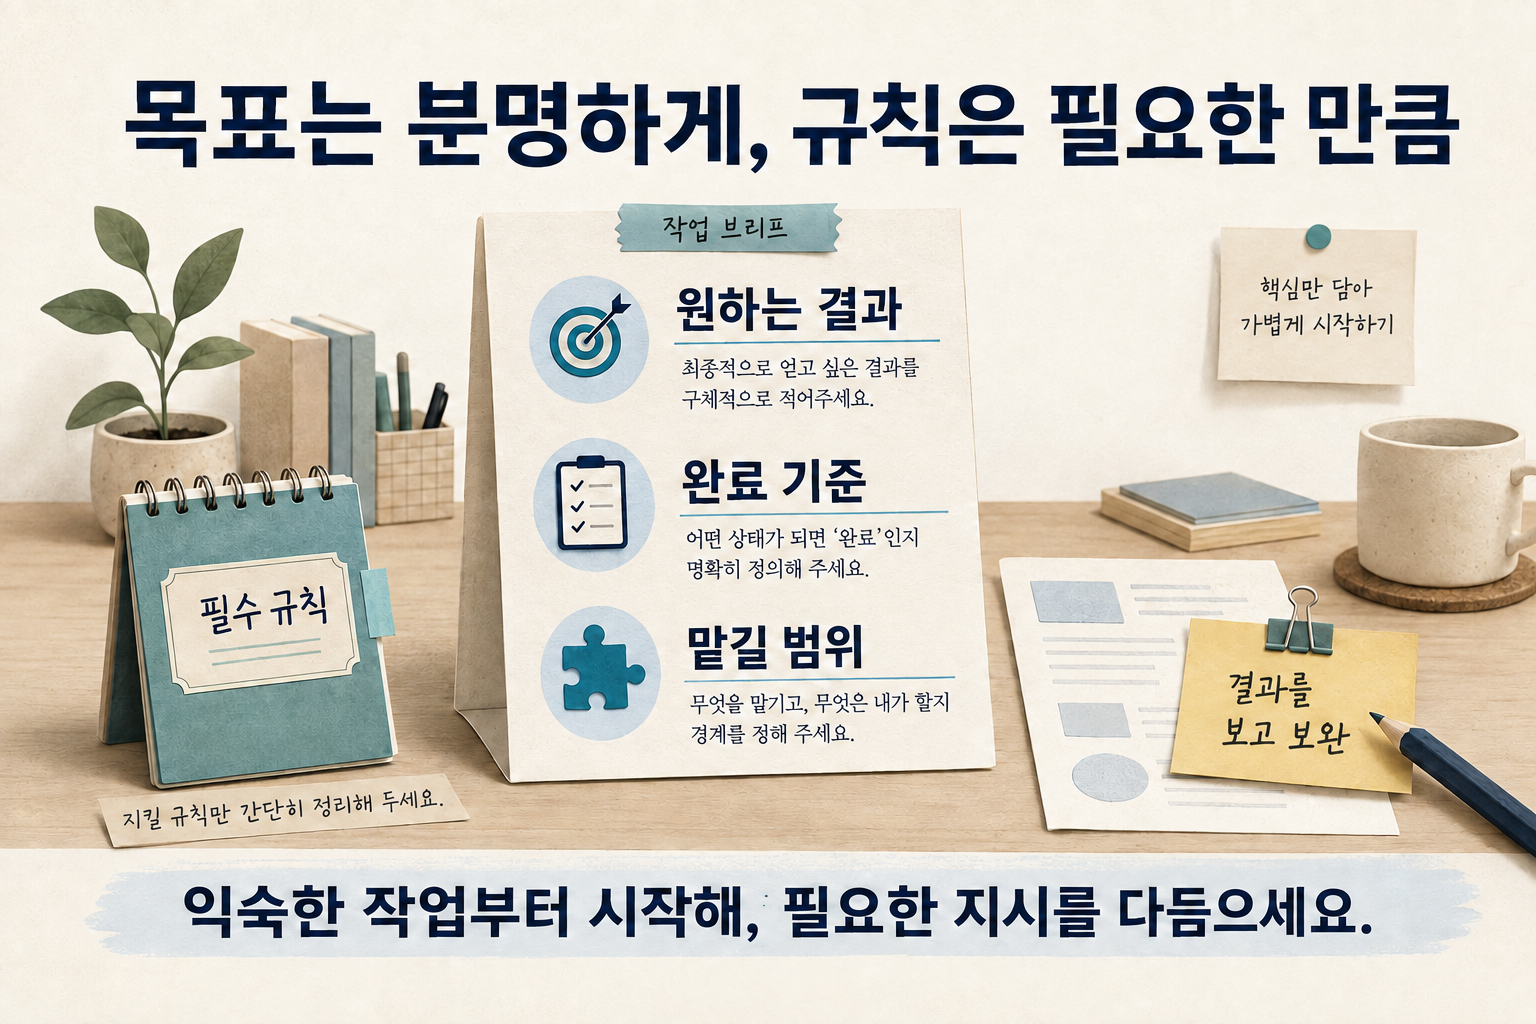
3.1 원하는 결과는 분명하게, 규칙은 필요한 만큼
처음부터 모든 상황을 예상해 긴 지시문을 만들 필요는 없습니다.
평소 쓰던 자료에 원하는 결과·완료 기준·스스로 진행해도 되는 범위를 붙여 시작하고, 결과를 보며 필요한 규칙을 하나씩 더하는 편을 권합니다.
다음은 문서 작업에 쓸 수 있는 요청 예시입니다.
첨부한 보고서와 회의록으로 고객 제안서 초안을 작성해줘. 핵심 제안, 근거, 일정, 미결 사항을 포함하고 근거 문서를 표시해줘.
문서 구성과 표현은 알아서 정리하되, 자료에 없는 수치와 대외 약속은 확인이 필요한 항목으로 남겨줘. 초안 작성과 출처 대조까지 진행해줘.
작업을 맡긴 뒤에는 만족스럽지 않았던 부분을 다음 지시에 반영하면 됩니다.
만약 표현이 장황했다면 원하는 분량과 문체를 알려주고, 확인 질문이 잦았다면 어떤 판단까지 맡겨도 되는지 구체화하는 식입니다.
더 나아가, 여러 작업에서 반복해 쓰게 된 지시가 있을 경우
그때 프로젝트 규칙이나 스킬로 정리해두면 좋겠습니다.
처음부터 규칙을 늘리기보다, 내 업무에서 유용했던 방식을 작업 절차로 남기며
내 업무에 맞는 자동화 방식을 만들어가는 것입니다.
3.2 기존 지시 파일과 질문·검증 범위 조정하기
코딩 에이전트라면 AGENTS.md나 스킬 파일도 함께 살펴볼 만합니다.
이는 에이전트가 참고하는 프로젝트 규칙과 작업 절차가 들어 있는 파일입니다.
공식 가이드는 Astra가 이런 지시에 민감하게 반응하므로
관련 지시 파일을 점검하라고 강하게 권합니다.
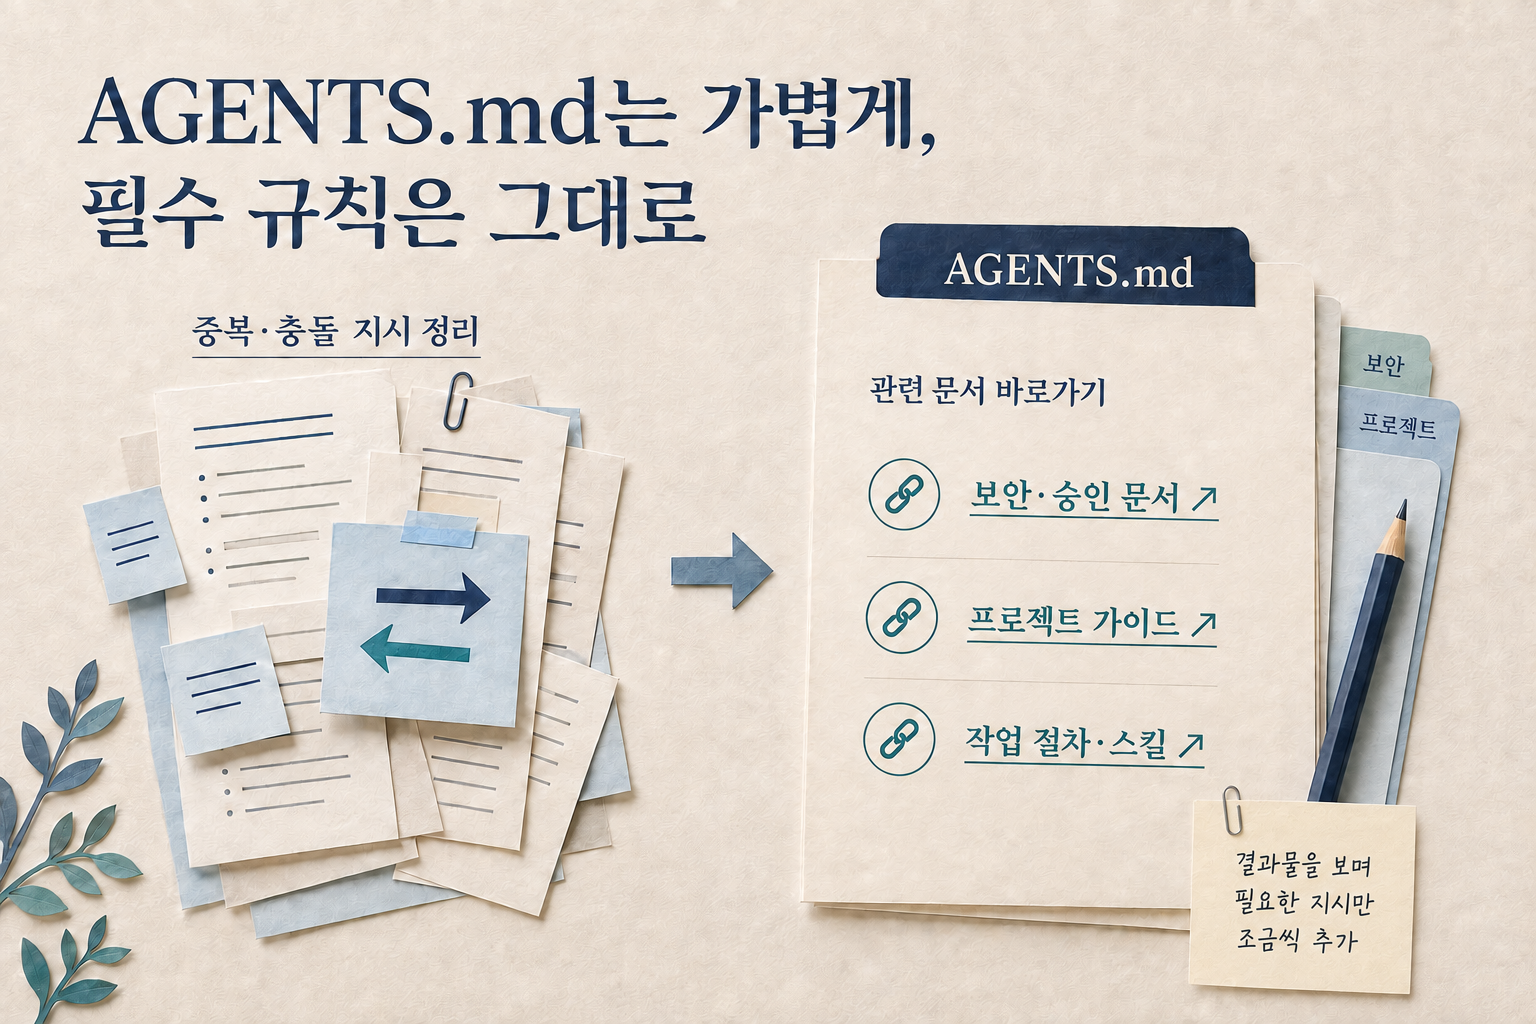
예를 들어 서로 상반된 지시가 있으면 Astra는 큰 혼란을 겪습니다.
요청에는 “초안까지 진행해줘”, 파일에는 “작성 전 반드시 확인받기”처럼 둘 중 어떤 지시를 따를지 모호한 경우가 종종 발생합니다.
예상 밖의 시점에서 작업이 멈춘다면 어느 파일의 어떤 지시 때문에 멈췄는지 물어보고, 실제 의도와 어긋나는 규칙을 적절히 조정하세요. 지시 파일 점검 안내
주로 정리할 우선 순위 대상은
과거 Sol 모델에 맞춰 쌓아둔 '특정 행위 억제로 인한 충돌 유발 지시'입니다.
이런 지시 잔재로 인해 사용자가 의도하지 않은 질문을 유발할 수 있습니다.
물론 보안·승인·프로젝트의 필수 조건 등 중요한 맥락는 계속 명확히 제공하는 편이 좋겠습니다.
확인 질문을 하는 경향에 더해
Astra가 선호하는 작업 방식 중 하나는
검증 범위나 하위 에이전트 활용 방식도 지시로 조정해주길 원한다는 점입니다.
만약 작은 변경에 검증이 지나치게 넓어진다고 판단되면
관련 검증 기준부터 명확히 정리하고,
독립 작업이 순차적으로 길어진다면
필요한 작업을 하위 에이전트 기반 병렬 작업으로 나누도록 기준을 정하는 식입니다. 행동 조정 가이드
4. 더 넓게 맡기기 위한 안전과 작업 경계
다만, Astra의 자율 처리 범위가 확대될수록 더 큰 주의가 요구됩니다.
사용자는 작업 결과를 엄격히 검토하고, 민감한 사안에 대해서는 사람의 승인 절차를 반드시 마련해야 합니다.
OpenAI는 Astra가 사이버 역량의 Critical 기준에 도달했다고 평가했습니다.
적절한 도구와 권한 아래에서, 견고하게 보호된 여러 시스템의 알려지지 않은 결함을 찾고 사람의 단계별 안내 없이 악용 방법을 개발할 수 있다는 설명입니다.
물론 이는 사이버 공격을 수행할 수 있는 역량의 분류 단위를 의미하지,
Astra의 안전성이 낮다고 인증하는 등급은 아닙니다.
이에 보호 조치도 강화됐으며, 추가 안전 검사가 정상 작업을 늦추거나 중단할 수 있다고 안내합니다. OpenAI 역량 분류·사용자 영향
『An Alien Mind』에서 OpenAI 수석과학자 야쿠프 파초키는
GPT-5.5에서 Sol로, Astra로 넘어오며 사람의 의도에 맞게 행동하는 ‘정렬’이 개선됐다고 평가합니다.
정렬이 개선됨과 동시에 '모델이 말로 드러내는 중간 추론에 의존한 감시'에는 신뢰가 약해졌다고 설명하고 있습니다. 파초키의 정렬·감시 논의
기존 감시 방식은 모델이 뱉어내는 중간 추론 단계에서 주로 진행이 됩니다.
생각 단계에서 위험한 요소가 식별될 경우 동작을 막아내는 가드레일 방식이죠.
그러나 긴 풀이를 말로 쓰지 않고도 어려운 문제를 풀게 된다면?
자연스레 감시자가 읽을 수 있는 단서가 줄어듭니다.
추가로 원문은 모델의 정렬이 개선될수록 자신의 추론 과정을 분석하고, 숨기기 위해 조작하는 능력도 커지고 있다고 설명합니다.
다만 이를 ‘정렬이 개선될수록 일부러 과정을 숨긴다’는 인과관계로 섣불리 해석해서는 안된다는 관점이 공존합니다.
의도에 맞게 행동하도록 만드는 것과, 그 과정을 신뢰할 만하게 감시하는 것은 별개의 과제라는 이야기입니다.
별도로 연구자 Sergey Berezin은 공개 ChatGPT에서 Astra의 응답 제한을 우회하는 ‘탈옥’을 보고했습니다.
전체 프롬프트와 재현 자료는 OpenAI에 비공개 전달했다고 밝혀, 공개 자료만으로 영향 범위를 확인하기는 어렵습니다.
물론 이 보고와 앞선 감시 문제의 인과관계도 확인되지 않았기에
현상을 바라볼 때 비판적인 시선이 필요합니다. 연구자 보고와 공개 범위
5. 다음 작업 하나를 Astra에 맡겨보자
Astra에서 기대되는 변화는 조사·구현·화면 확인·수정처럼 이어지는 작업을 더 길게 맡기는 데 있습니다.
Sol을 사용해왔다면 익숙한 웹 앱 개선이나 자료 기반 문서 작성부터 시작해보면 좋겠습니다.
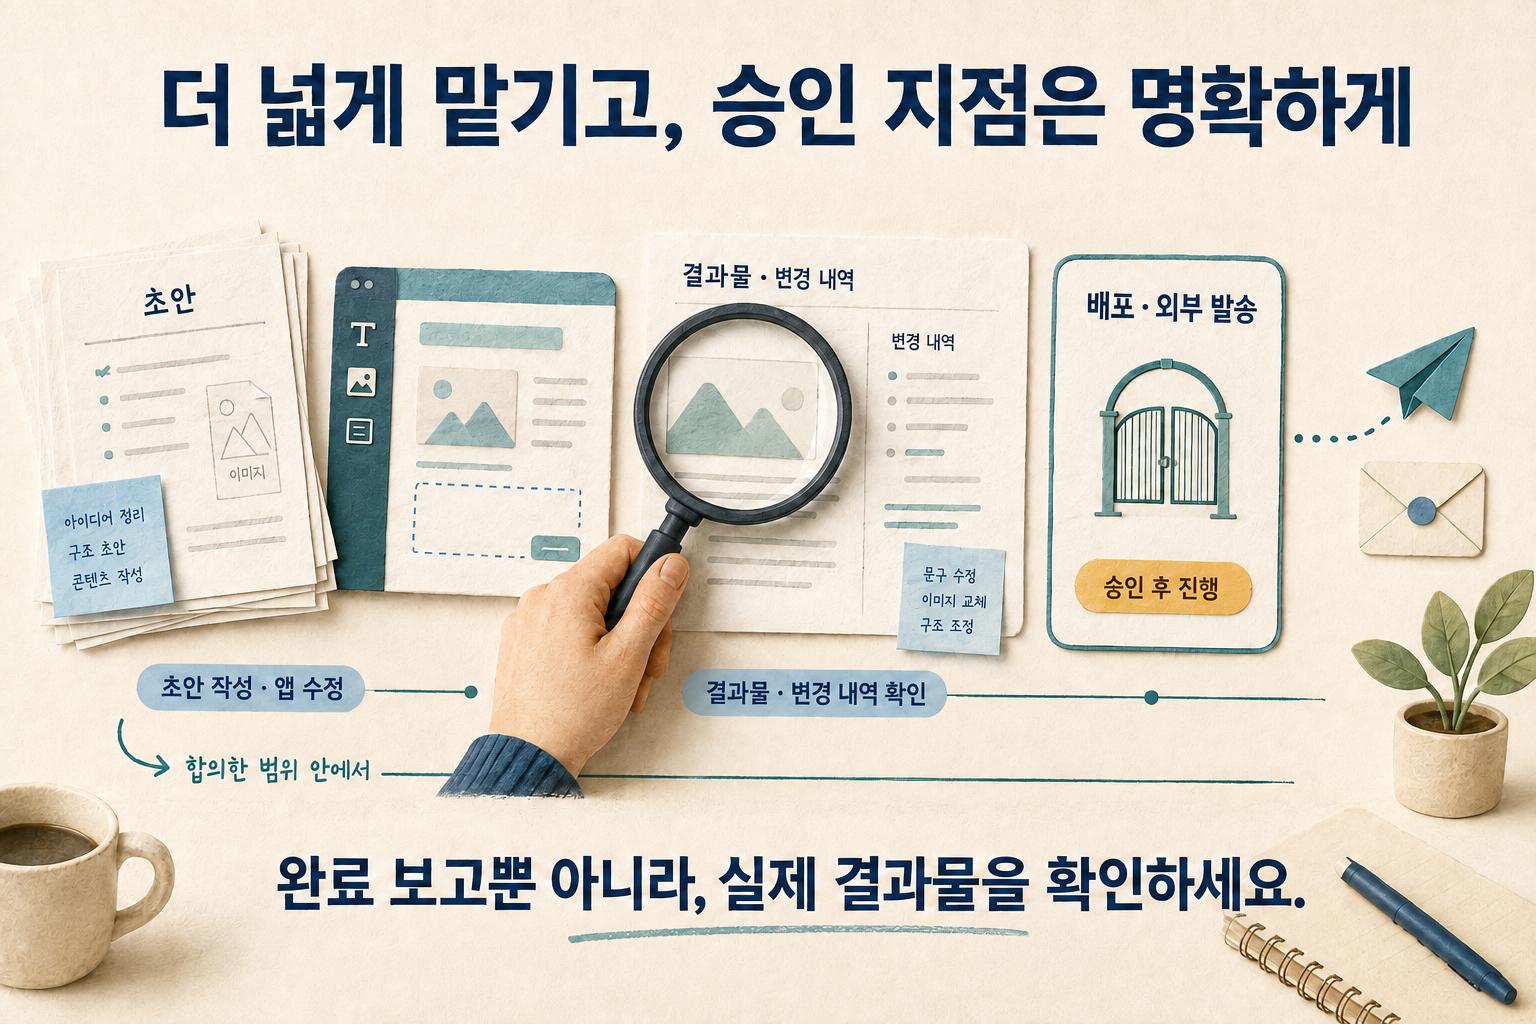
이때 제가 제안하는 협업 원칙은 완료 보고뿐 아니라 결과물과 변경 내역을 확인하고, 그 결과를 다음 지시에 반영하는 것입니다.
문서라면 인용한 근거가 결론을 뒷받침하는지, 코드라면 요청한 범위가 수정되고 필요한 검증을 통과했는지를 살펴보는 식입니다.
앱 수정과 배포, 문서 작성과 외부 발송은 구분해 권한을 주고, 어느 시점에 사람이 확인할지도 정해두면 좋겠습니다.
끝까지 맡겨볼 작업 하나를 건네고, 결과를 확인해 다음 지시를 다듬으며 맡기는 범위를 넓혀가는 것.
저는 이 반복이 Astra의 개선을 내 업무의 가치로 바꾸는 가장 구체적인 출발점이라고 생각합니다.
참고 A. 구독 사용자: 모델 선택과 사용량
앞에서는 Astra에 무엇을 맡기고 어떻게 조정할지 살펴봤습니다. 아래는 실제 사용을 시작할 때 필요한 이용 조건·설정·비용 안내입니다.
구독 앱을 쓰는 분은 참고 A를, 직접 API를 연결하는 분은 참고 B를 골라 읽으셔도 됩니다.
구독제를 통해 ChatGPT 앱이나 Codex 데스크탑 앱에서 사용한다면,
먼저 계정에서 Astra를 선택할 수 있는지 확인하고 Sol로 하던 작업 한 건을 맡겨보면 됩니다.
이용 가능 여부는 요금제와 배포 단계에 따라 달라집니다. 모델 이용 안내
구독 앱에서 모델을 선택하는 데 API 이전 작업은 필요하지 않습니다.
Pro 사용자라면 API 단가보다 먼저 구독 사용량을 보면 됩니다.
ChatGPT의 작업 기능인 Work와 코딩 에이전트 Codex는 사용량을 공유합니다.
각각 별도의 무제한 작업 몫이 있는 구조가 아니며, 작업 크기와 설정에 따라 소모량도 달라집니다. Work·Codex 사용량과 요금제별 조건
공식 안내의 5시간당 로컬 메시지 수 추정치를 비교하면 다음과 같습니다.
로컬 메시지는 데스크톱 앱·Codex CLI·IDE 확장 등에서 로컬 작업을 진행하며 주고받는 메시지를 뜻합니다. 일반 ChatGPT 대화 전체의 횟수 표는 아닙니다.
Pro 5x와 Pro 20x는 Plus 대비 Codex 사용량을 각각 5배·20배 제공하는 요금제 구분입니다.
| 모델 | Plus | Pro 5x | Pro 20x |
|---|---|---|---|
| Astra | 5~45 | 25~225 | 100~900 |
| Sol | 10~100 | 50~500 | 200~2,000 |
2026년 9월 7일 기준. 고정 요청 한도나 완료 가능한 작업 수가 아닙니다. 모델마다 별도 몫이 생기는 것도 아니며, 클라우드 작업은 소모량이 다를 수 있고 주간 한도도 적용될 수 있습니다. 실제 남은 사용량과 초기화 시각은 계정 대시보드가 기준입니다. 공식 추정치와 조건
따라서 Sol에서 하던 긴 작업을 Astra로 옮긴다면, 첫 몇 건에서 결과의 개선과 사용량 소모를 함께 살펴보면 작업 규모를 잡는 데 도움이 됩니다.
참고 B. API 개발자: 비용과 요청 설정
API를 직접 연결한다면 이용 비용과 요청 호환성을 함께 살펴봐야 합니다. 먼저 비용을 가늠한 뒤, 기존 코드에서 바꿀 부분을 확인하겠습니다.
B.1 비용: 반복 입력과 출력량을 함께 보기
API로 직접 운영한다면 구독 사용량과 별도로 비용을 계산해야 합니다.
예를 들어 긴 보고서 하나로 요약문을 만든 뒤, 같은 자료에서 비교표와 제안서를 이어서 만든다고 해보겠습니다. 매번 자료를 보내는 비용에 결과물을 생성하는 비용이 더해집니다.
이때 캐시가 적용되면 반복되는 입력 부분을 재사용할 수 있습니다. 처음 저장할 때의 ‘캐시 쓰기’와 다시 사용할 때의 ‘캐시 읽기’ 단가가 달라, 같은 자료를 얼마나 재사용하느냐도 비용에 영향을 줍니다. 새로 생성하는 출력 비용은 별도입니다.
가격표의 토큰은 모델이 텍스트를 처리하는 단위로, 글자 수와 정확히 같지는 않습니다.
아래는 Standard 처리, 입력 272,000토큰 이하 기준이며 단위는 100만 토큰당 미국 달러입니다.
| 항목 | Astra | Sol |
|---|---|---|
| 입력 | $10.00 | $4.00 |
| 캐시 읽기 | $1.00 | $0.40 |
| 캐시 쓰기 | $12.50 | $5.00 |
| 출력 | $50.00 | $20.00 |
2026년 9월 7일 공식 가격표 기준. Sol은 프로모션 요금이며 긴 입력·Fast 모드는 별도 조건이 적용됩니다.
표의 단가는 2.5배지만 작업 비용은 호출 수·출력량·재시도에 따라 달라집니다. 반복 작업은 청구액과 사람이 수정한 시간을 함께 기록하면 운영 규모를 잡기 좋습니다.
B.2 연결: 요청 방식과 호환 설정 확인
비용을 살펴봤다면, 기존 요청 코드에서는 요청 방식, 추론 강도, 미지원 매개변수 세 가지부터 확인하면 됩니다.
구독 앱에서 Astra를 선택하는 것과 달리, 개발자는 요청 코드도 조정해야 할 수 있습니다.
1. 도구를 쓴다면 Responses로
Responses와 Chat Completions는 프로그램이 모델에 요청을 보내는 API 방식입니다. 같은 텍스트 요청도 다음처럼 형태가 다릅니다.
Chat Completions의 요청 본문(POST /v1/chat/completions):
{
  "model": "gpt-6-astra",
  "messages": [{"role": "user", "content": "회의록을 세 줄로 요약해줘: …"}],
  "reasoning_effort": "low"
}
Responses의 요청 본문(POST /v1/responses):
{
  "model": "gpt-6-astra",
  "input": "회의록을 세 줄로 요약해줘: …",
  "reasoning": {"effort": "low"}
}
텍스트 요청의 구조만 비교한 예시로, 인증·도구 설정은 생략했습니다. messages와 input, 추론 설정을 넣는 위치가 다릅니다. 요청 형식 이전 안내
중요한 차이는 Astra의 도구 호출에는 Responses가 필수라는 점입니다. 비동기 도구 호출을 사용할 때만 적용되는 요건이 아닙니다.
검색이나 파일 조작 등 외부 기능을 호출한다면 Responses로 옮겨야 합니다. 반면 텍스트 요청에는 Chat Completions도 계속 사용할 수 있으므로, 기존 API 전체가 종료됐다는 뜻은 아닙니다.
2. 추론 강도는 유효한 기존 값부터
추론 강도는 문제를 생각하는 데 들일 노력을 조절하는 설정입니다.
기존에 유효한 값을 썼다면 유지하고, Astra가 지원하지 않는 none·minimal을 썼다면 low부터 시작합니다. 위 예시의 low가 모든 작업의 권장값이라는 뜻은 아닙니다.
3. 남아 있는 미지원 설정 제거하기
이전 요청을 그대로 복사했다면 아래 항목이 남아 있는지 확인하세요. 해당 항목이 없다면 삭제할 것도 없습니다.
| 확인 위치 | 제거할 항목 |
|---|---|
| 두 API 공통 | temperature, top_p, top_logprobs |
| Chat Completions | logprobs |
Responses의 include 배열 |
message.output_text.logprobs 항목만 제거 |
모델명과 위 설정을 바꾼 뒤에는,
먼저 짧은 텍스트 요청이 정상 응답하는지 확인합니다. 도구를 쓴다면 도구 호출부터 결과 전달, 최종 응답까지 이어지는 작은 작업도 한 건 실행해보면 됩니다.
그래야 요청 호환 문제와 결과물 품질을 나눠 살펴보기 쉽습니다. 공식 이전 요건
B.3 대기 중에도 작업을 이어가는 기능
기본 요청이 동작하면, Responses에서 제공하는 두 기능으로 작업 중 대기와 방향 수정도 다뤄볼 수 있습니다.
- 비동기 도구 호출: 외부 조회가 끝나기 전에 그 결과와 무관한 일을 계속합니다. 예를 들어 가격 조회를 기다리며 이미 확보한 제품 설명을 정리하는 식입니다. 도구 실행과 결과 전달은 개발자의 프로그램이 담당합니다. OpenAI 기능 설명·구현 예제
- 중간 지시: 응답이 끝나기 전에 “비교 대상에 이 제품도 추가해줘” 같은 요구를 보냅니다. 연결을 유지하며 메시지를 주고받는 WebSocket 방식을 사용합니다. 진행 중인 출력·도구 작업을 즉시 취소하지 않고 이어지는 응답에 반영합니다. OpenAI 지시 반영 방식
위 제품 비교는 활용을 설명하기 위한 예시입니다.
이 두 기능의 활용 가치는 조회 대기와 방향 수정 때문에 전체 작업이 멈추는 상황을 줄이는 데 있습니다.
Responses API로 요청 방식만 바꾼다고 결과 품질이나 모델의 추론 속도가 자동으로 개선되는 것은 아닙니다. 필요한 기능을 프로그램에 연결했을 때 작업 흐름을 개선할 수 있다는 의미입니다.