
쿠버네티스 HPA로는 부족하다면? KEDA로 구축하는 이벤트 기반 AI 오토스케일링
TL;DR (3줄 요약)
- 비용과 반응 속도 해결: 쿠버네티스 기본 HPA의 한계를 넘어, KEDA를 통해 메시지 큐 기반의 선제적 스케일링과 완벽한 0으로의 축소(Scale-to-Zero)를 달성해 비싼 유휴 GPU 비용을 제거합니다.
- 콜드 스타트 파이프라인 설계: 스케일 아웃 시 발생하는 3단계 지연(노드 ➔ 컨테이너 ➔ 모델 부팅)을 돌파하기 위해, 인프라 환경(DIY/클라우드)에 맞는 최적의 모델 로딩 아키텍처를 선택해야 합니다.
- 스케일링 딜레이 방어: KEDA의
cooldownPeriod를 활용해 파드를 즉시 죽이지 않고 웜(Warm) 상태로 잠시 유지함으로써, 잦은 콜드 스타트 없이 매끄러운 추론 서비스를 제공할 수 있습니다.
AI/ML 워크로드를 프로덕션 환경에서 운영해 본 분들이라면 모두 공감하는 고충이 있습니다. 바로 GPU는 무서울 정도로 비싸다는 것입니다.
트래픽이 몰릴 때는 지연 시간(Latency)을 막기 위해 추론(Inference) 파드를 빠르게 늘려야 합니다. 하지만 트래픽이 뜸한 새벽 3시에도 거대한 GPU 파드들을 계속 띄워둔다면, 아무 일도 하지 않는 유휴 컴퓨팅 자원에 수백만 원을 버리는 셈이 됩니다.
보통은 쿠버네티스에 내장된 기본 HPA(Horizontal Pod Autoscaler)로 이 문제를 해결할 수 있다고 생각합니다. 하지만 AI 추론 워크로드에 기본 HPA를 그대로 사용한다면, 매우 비효율적인 스케일링을 경험하게 될 것입니다.
왜 기본 쿠버네티스 오토스케일러가 ML 추론에 부적합한지, 그리고 어떻게 KEDA(Kubernetes Event-driven Autoscaling)가 더 똑똑하고 효율적인 스케일링을 가능하게 하는지 알아볼까요?
문제점: 수동적이고 제한적인 기본 HPA
기본 쿠버네티스 HPA는 CPU나 메모리 같은 '리소스 사용량'을 기준으로 파드를 스케일링합니다. 이는 마치 융통성 없는 버스 정류장의 배차 관리자(HPA)와 같습니다.
대기열(Queue)에서 이미지를 가져와 처리하는 추론 파드가 한 대의 '버스'라고 가정해 봅시다. 이미지 하나를 처리하는 데 5초가 걸리고, 이 동안 파드의 CPU 및 GPU 사용률은 100%를 찍습니다. 하지만 HPA 관리자는 해당 파드가 만원(과부하) 상태만 보고, 등 뒤로 대기 중인 승객(요청 큐)이 10명인지, 10,000명인지 전혀 보지 못합니다.
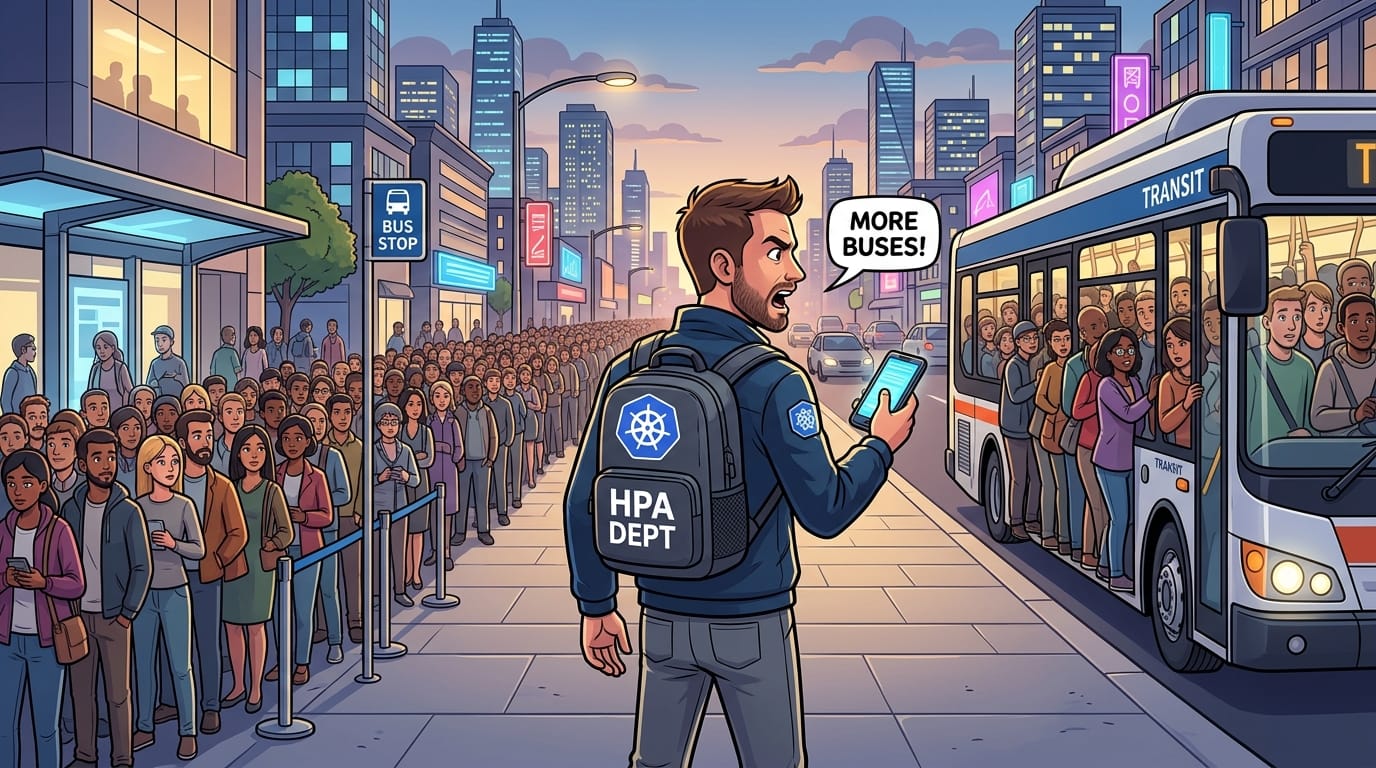
결국 HPA는 눈앞의 파드(버스) 상태가 100%로 한계에 달한 것을 확인한 뒤에야 수동적(Reactive)으로 반응하며 느릿느릿 파드를 늘립니다. 만약 뒤에 만 명의 대기열이 있다는 사실을 큐를 통해 미리 알았다면 선제적으로 버스 수백 대를 불렀겠지만, HPA는 그럴 능력이 없습니다.
더 심각한 것은 기본 HPA는 0으로 스케일 다운(Scale-to-Zero)을 할 수 없다는 점입니다. 지표를 수집하려면 항상 최소 1개의 파드(버스)가 운행 중이어야 하기 때문에, 탈 승객이 아무도 없는 새벽 시간대에도 최소 1대의 비싼 GPU 버스 유지비를 무조건 지불해야 합니다.
해결책: KEDA 관제탑과 이벤트 기반 스케일링
KEDA(Kubernetes Event-driven Autoscaling)는 이 답답한 배차 시스템에 '스마트 관제탑'을 세워줍니다. KEDA 엔지니어는 눈앞의 버스(파드)가 꽉 찰 때까지 무작정 기다리지 않습니다. 대신 승객 대기열(메시지 큐: Redis, Kafka 등) 전체를 태블릿으로 직접 모니터링합니다.
만약 정류장에 1,000명의 승객(요청)이 갑자기 몰려들면, KEDA 관제탑은 즉시 필요한 버스 수를 계산하고, 첫 번째 승객이 버스에 타기도 전에 선제적으로 50대의 빈 버스(파드)를 한 번에 증차해 버립니다.
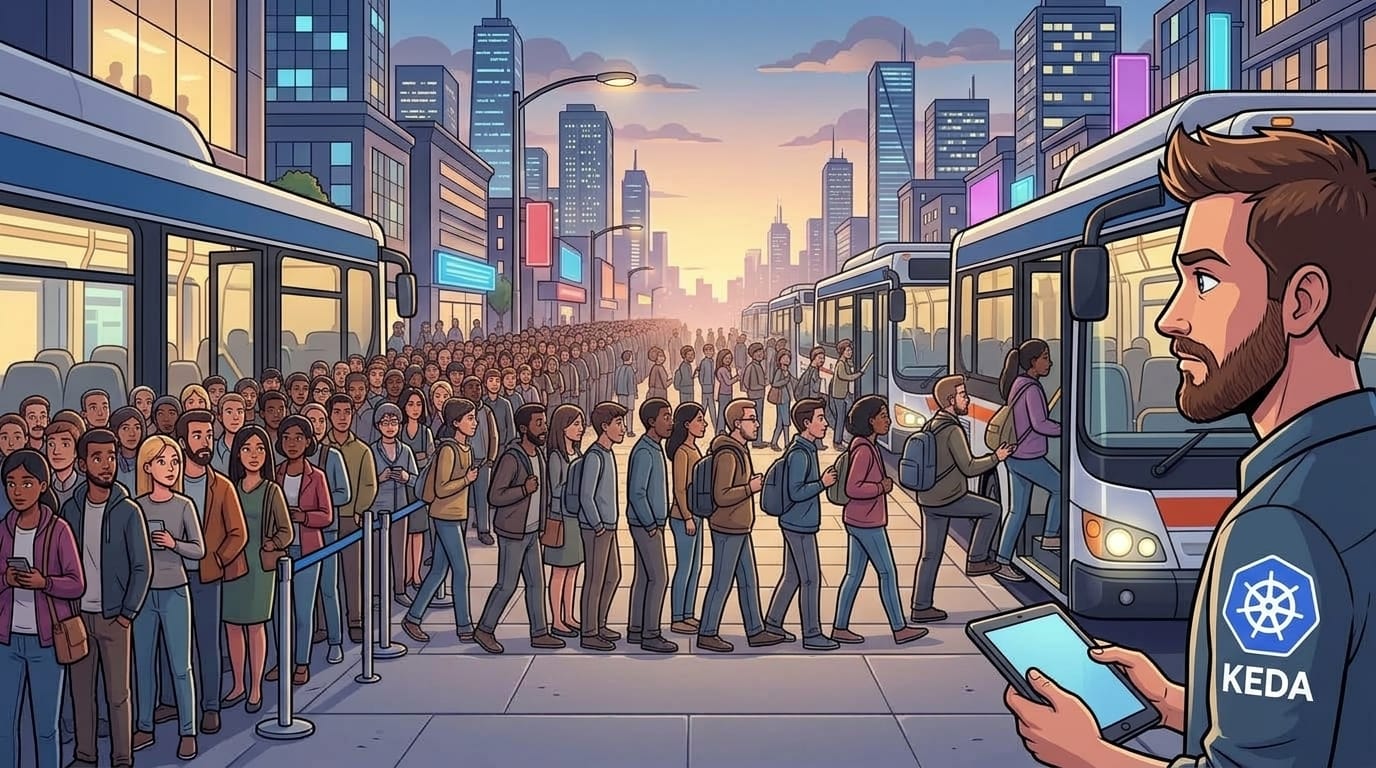
그리고 가장 중요한 마법은 승객이 한 명도 없을 때 일어납니다. 큐가 텅 비었다는 것을 확인한 KEDA는 기존 HPA의 한계를 무시하고 버스 배차를 완전히 0대(Scale-to-Zero)로 줄여버립니다. 텅 빈 버스가 연료(인프라 비용)를 태우며 공회전하는 것을 원천적으로 차단하는 것입니다.
KEDA가 "파드를 50개로 늘려라!"라고 쿠버네티스에 지시하는 것은 1초면 끝납니다. 하지만 실제로 거대한 ML 컨테이너를 부팅하고 로드하여 첫 트래픽을 처리하기까지의 과정은 매우 험난합니다. 이를 직접 구축하는 환경에서 겪는 3단계의 끔찍한 병목과, 이를 현대적인 아키텍처로 어떻게 쉽게 해결할 수 있는지 살펴보겠습니다.
1단계: 노드 부팅 (인프라 지연)
KEDA가 트래픽 스파이크를 감지하고 10개의 새 파드를 요청하면, 클러스터에는 이를 실행할 물리적 GPU 노드가 있어야 합니다.
- 직접 구성할 때 한계 및 문제점: 직접 클러스터를 구축하면 트래픽 스파이크 시 유휴 자원 부족으로 확장이 불가능해지거나, 무거운 오픈소스 오토스케일러를 억지로 연동해야 합니다. 새 VM을 프로비저닝(On-premise 혹은 클라우드 환경)하고 클러스터에 편입시키는 과정만 수 분이 걸립니다.
- 강력한 인프라가 있다면: 초고속 노드 프로비저닝 기술과 최적화된 웜 풀(Warm Pool) 관리를 결합하여 해결할 수 있습니다. KEDA가 스케일 아웃을 지시했을 때, 인프라 지연을 거의 느끼지 못할 정도로 매끄럽게 GPU 노드가 확장되는 환경을 구축해야 트래픽 버스트를 방어할 수 있습니다.
2단계: 컨테이너 부팅 (이미지 풀링)
노드가 준비되면 쿠버네티스는 이미지를 다운로드해야 합니다. ML 이미지는 CUDA 드라이버와 파이썬 의존성 때문에 용량이 매우 큽니다.
- 직접 구성할 때 한계 및 문제점: 10GB가 넘는 이미지를 노드마다 직접 당겨오는 것은 악몽입니다. 50개의 노드가 동시에 풀링을 시도하면 네트워크 대역폭이 포화되며, 이를 막기 위해
DaemonSet으로 노드마다 미리 이미지를 깔아두는 무거운 스크립트를 직접 짜고 관리해야 합니다. - 강력한 인프라가 있다면: 수십에서 수백 Gbps에 달하는 강력한 내부 네트워크 대역폭이 갖춰져 있다면, 다수의 노드가 대용량 이미지를 동시에 다운로드해도 네트워크 병목이 발생하지 않습니다. 더불어 인프라 레벨에 지연 풀링(Lazy 풀링) 기술까지 통합되어 있다면, 이미지 다운로드를 기다릴 필요 없이 컨테이너가 수 초 이내에 정상적으로 실행됩니다.
3단계: 모델 부팅 (스토리지에서 VRAM으로)
컨테이너는 실행되었지만, 거대한 모델 가중치(예: 20GB의 .safetensors 파일)를 스토리지에서 시스템 RAM을 거쳐 PCIe 버스를 통해 GPU VRAM으로 로드하기 전까지는 트래픽을 처리할 수 없습니다.
- 직접 구성할 때 한계 및 문제점: 값비싼 로컬 NVMe 스토리지를 물리 머신마다 직접 꽂아
HostPath로 관리하거나, 파드가 뜰 때마다 오브젝트 스토리지에서 가중치를 매번 다운로드해야 합니다. 동시 다운로드는 네트워크를 마비시키고 스케일 아웃을 실패로 이끕니다. - 강력한 인프라가 있다면: 일반적인 로컬 SSD 디스크가 아닌, 고속 네트워크로 연결된 고성능 공유 스토리지를 활용한다면 I/O 병목을 근본적으로 해결할 수 있습니다. 다수의 파드가 동시에 생성되더라도, 고성능 스토리지 특유의 압도적인 IOPS를 바탕으로 다운로드 과정 없이 메모리 맵핑(
mmap)을 통해 가중치를 즉시 로드할 수 있습니다.
아키텍처의 기로: 모델을 구워 넣을 것인가, 동적으로 로드할 것인가?
여담으로 위 단계 도중 추가적으로 다음과 같은 상황을 고려해야 합니다; "도커 이미지 안에 모델 가중치를 포함(Bake)할 것인가, 아니면 런타임에 동적으로 로드(Dynamic Loading)할 것인가?"
- 이미지 안에 모델 구워 넣기 (Container-Heavy 접근법)
docker build과정에서COPY로 거대한 모델 파일을 30GB짜리 이미지 안에 직접 넣습니다.- 장점: 2단계와 3단계가 합쳐집니다. 이미지만 풀링되면 모델 파일이 로컬에 존재하므로 바로 VRAM에 올릴 수 있습니다. 추가적으로 해당 이미지를 이미 캐시에 가지고 있는 노드는 파드를 더 빠르게 올릴 수 있습니다.
- 단점: 이미지가 너무 커져 지연 풀링(Lazy Pulling) 기술이 갖춰져 있지 않다면 2단계(컨테이너 부팅)가 끔찍하게 느려집니다.
- 만약 이미지 내부에 있는 모델이 자주 변하지 않거나 동적으로 모델을 로드하기에는 네트워크 환경이 열약할 때 고려해볼만 합니다.
- 런타임에 모델 동적 로딩 (Storage-Heavy 접근법) 도커 이미지는 500MB 수준의 런타임 환경으로 가볍게 유지하고, 모델 가중치는 파드가 실행될 때 고성능 공유 스토리지에서 마운트하여 로드합니다.
- 장점: 이미지가 가벼워 진행이 빠르며, 2단계(컨테이너 부팅)가 수 초 만에 끝납니다.
- 단점: 50개의 파드가 20GB 가중치를 동시에 읽어들일 때 발생하는 부하를 견뎌낼 수 있는 '고성능 공유 파일 시스템' 및 네트워크 환경이 인프라에 반드시 뒷받침되어야 합니다.
- LoRA와 같이 요청 때마다 모델을 갈아 끼워야 하거나, 모델 업데이트가 자주 일어날 경우 및 해당 모델이 상대적으로 가벼울 때 적합합니다.
결론: KEDA가 벌어다 주는 '시간'
결국 KEDA는 '언제(When)' 스케일링할지를 결정하지만, 인프라는 '얼마나 빨리(How fast)' 로드할 수 있는지를 결정합니다.
KEDA는 큐의 상태를 정확히 이해하기 때문에 cooldownPeriod(예: 5분)를 설정할 수 있습니다. 큐가 0이 되어도 KEDA는 파드를 즉시 죽이지 않고 5분간 의도적으로 대기합니다. 이렇게 파드를 '웜(Warm)' 상태로 유지함으로써, KEDA는 트래픽이 들쭉날쭉한 상황에서도 사용자가 이 험난한 부팅 파이프라인(노드-컨테이너-모델)을 매번 기다리지 않도록 든든한 방패막이가 되어줍니다.
또한 HPA와 달리 선제적으로 오토스케일링을 진행할 수 있기에 비교적 빨리 파드를 요청하여 쿠버네티스와 인프라가 대응할 수 있는 시간을 추가적으로 확보할 수 있습니다.